Interne Suchergebnisse sollten nicht allein deshalb indexierbar sein, weil Besucher sie aufrufen können. Legen Sie fest, welche Suchaufgaben eine dauerhafte redaktionelle Zielseite verdienen. Steuern Sie anschließend Indexierung und Crawling getrennt: Ein robots.txt-Verbot verhindert nicht zuverlässig, dass eine bekannte URL im Index erscheint.
Zuerst Suchzustände von Zielseiten unterscheiden
Eine interne Suche kann nahezu beliebig viele Adressen erzeugen: andere Suchwörter, Sortierungen, leere Begriffe oder wiederholte Parameter. Diese Zustände sind nicht automatisch eigenständige Antworten für Suchmaschinen. Prüfen Sie, ob die Seite eine stabile Aufgabe erfüllt oder nur eine vorübergehende Ergebnisliste abbildet.
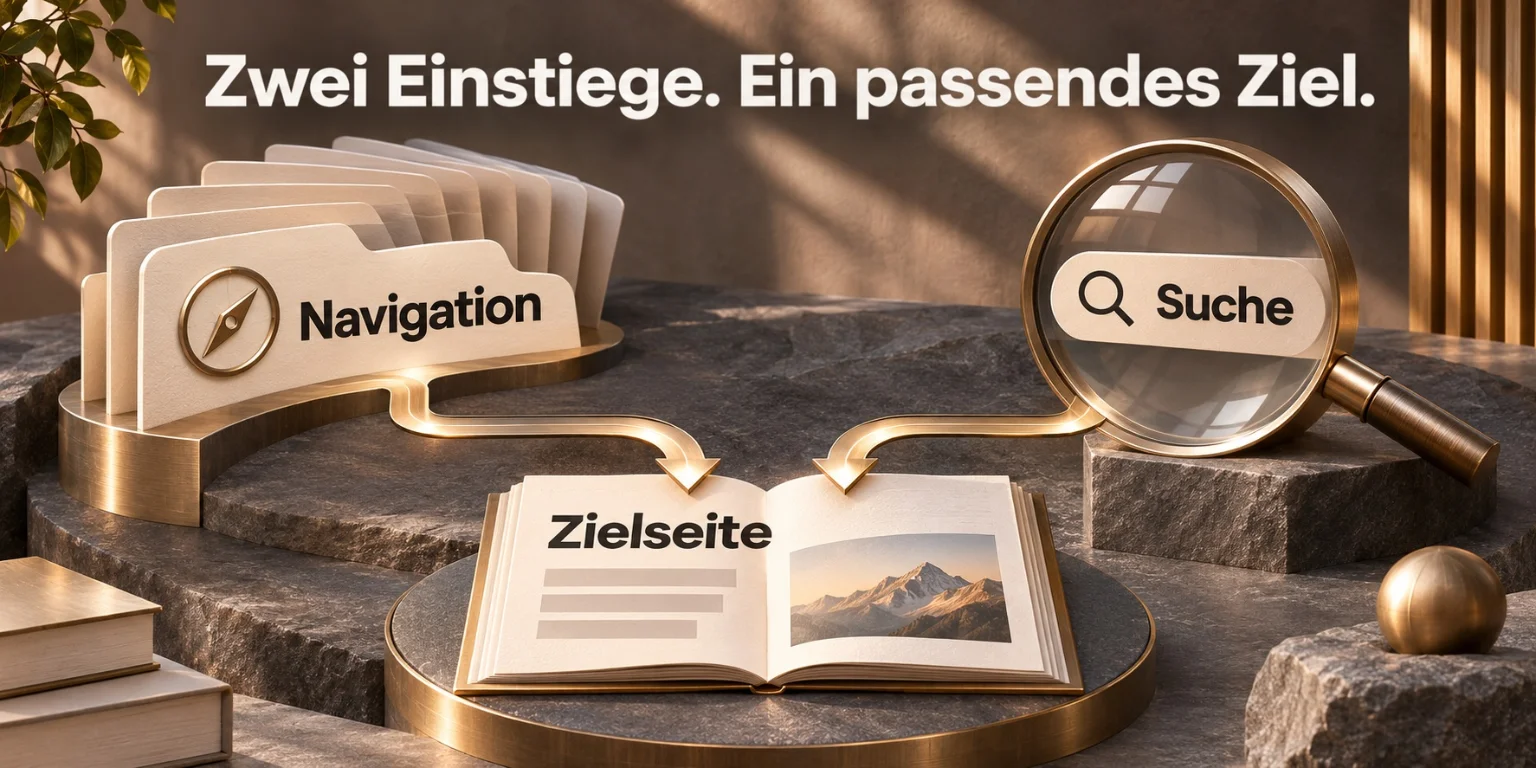
Bündeln Sie wiederkehrende, sinnvoll beantwortbare Nachfragen gegebenenfalls in einer gepflegten Kategorie- oder Ratgeberseite. Das ist eine redaktionelle Entscheidung und keine automatische Umwandlung jeder häufigen Suchphrase in eine Landingpage. Die gewählte Seite braucht eigenen Inhalt, eine verständliche Navigation und ein echtes Angebot beziehungsweise eine hilfreiche Antwort.
Weiterlesen: Navigation und interne Suche gemeinsam planen
noindex muss vom Crawler gelesen werden können
Ein noindex-Signal kann über ein Robots-Meta-Tag oder einen passenden X-Robots-Tag übermittelt werden. Damit Google es verarbeitet, muss der Abruf grundsätzlich möglich sein. Wer dieselben Adressen vorher in robots.txt sperrt, verhindert unter Umständen das Lesen der gewünschten Indexierungsanweisung.
Verwechseln Sie das mit Zugriffsschutz nicht: Eine ausgeschlossene Suchseite bleibt öffentlich erreichbar. Vertrauliche Informationen dürfen nicht durch öffentlich abrufbare Suchergebnisse sichtbar werden. Nutzen Sie für echte Vertraulichkeit die bestehenden geeigneten Zugriffskontrollen und prüfen Sie die tatsächlichen Antworten ohne angemeldete Sitzung.
Die passende Grundlage erläutert Crawling steuern: robots.txt und Zugriff unterscheiden.
Weiterlesen: Crawling steuern: robots.txt und Zugriff unterscheiden
Entscheidungen am konkreten Befund festmachen
| Prüffall | Entscheidung und Nachweis |
|---|---|
| Kurzlebige interne Suchliste | Indexierungsentscheidung separat treffen; keine automatische Landingpage. |
| Dauerhafte eigenständige Themenantwort | Eigene gepflegte Zielseite mit passendem internen Link erwägen. |
| noindex gewünscht | Abruf und tatsächlich ausgeliefertes Signal gemeinsam prüfen. |
| Vertrauliche Treffer | Zugriffsschutz prüfen; noindex ist keine Zugangssperre. |
Eine Ausschlussregel mit Gegenprobe dokumentieren
Ein praktisches Prüfblatt enthält eine Suchadresse mit Treffern, eine ohne Treffer und eine ausdrücklich erlaubte Kategorie. Für jede Adresse werden Status, tatsächliche Robots-Anweisung und robots.txt-Zugriff festgehalten. Die Kategorie ist die Gegenprobe: Sie darf nicht versehentlich dieselbe Ausschlussanweisung erhalten. Ein minimales illustratives HTML-Signal lautet <meta name="robots" content="noindex">. Das Beispiel ist keine Empfehlung für alle Suchseiten und kein Zugriffsschutz. Prüfen Sie die konkrete Ausgabe auch nach einem Templatewechsel; eine Regel im Verwaltungsformular belegt nicht deren Veröffentlichung.
Praxisfall: brauchbare Themen statt Suchwortseiten
Ein fiktiver Wissensbereich besitzt Suchadressen für „Rechnung“, „Rechnung “ und „rechnung?sort=neu“. Alle zeigen überwiegend dieselben Treffer. Eine eigenständige Hilfe zur Rechnung beantwortet dagegen Zuständigkeit, Voraussetzungen und den nächsten Schritt. Diese Hilfe bleibt die dauerhafte Zielseite; die wechselnden Suchzustände benötigen keine konkurrierenden Suchmaschinenadressen.
Prüfen Sie auch Links in Kategorien und Fußzeilen. Wenn diese ständig auf interne Suchabfragen zeigen, entsteht ein anderes Signal als bei einer dauerhaft redaktionell gewählten Themenadresse. Ersetzen Sie nur dort den Link, wo die feste Zielseite tatsächlich dieselbe Nutzeraufgabe erfüllt.
Eine Einführung braucht eine kontrollierte Stichprobe
Erfassen Sie vor einer Umstellung bekannte Such-URLs, aktuelle Indexhinweise und vorhandene Verlinkungen. Kontrollieren Sie anschließend den ausgelieferten Ausschluss und die Erreichbarkeit dieser Stichprobe. Die Verarbeitung durch Google kann später erfolgen; eine unmittelbar richtige technische Antwort ist noch kein Nachweis einer bereits abgeschlossenen Deindexierung.
Beobachten Sie neue URL-Muster nach Änderungen an Suche und Filtern. Vermeiden Sie pauschale Regeln, die versehentlich Produktkategorien oder redaktionelle Zielseiten treffen. Ein regelbasiertes Ausschließen muss mit erlaubten Gegenbeispielen getestet werden, damit nicht der gesamte hilfreiche Bestand dieselbe Anweisung erhält.
Die passende Grundlage erläutert Navigation und interne Suche gemeinsam planen.
Begriffe zu diesem Thema im Glossar nachschlagen →
Häufige Fragen.
Müssen interne Suchergebnisse grundsätzlich in Google stehen?
Nein. Prüfen Sie zuerst ihren dauerhaften Nutzwert und mögliche Überschneidungen. Eine interne Suchfunktion kann für Besucher wichtig bleiben, ohne jede Ergebnisadresse als eigenständige Suchmaschinenzielseite anzubieten.
Verhindert robots.txt die Indexierung sicher?
Nein. Eine bekannte gesperrte Adresse kann trotzdem im Index auftauchen. Außerdem kann eine Crawlsperre verhindern, dass Google einen auf der Seite gesetzten noindex-Hinweis liest.
Wo kann noindex technisch gesetzt werden?
Für HTML kommen ein Robots-Meta-Tag und ein geeigneter HTTP-Antwortheader infrage. Entscheidend ist die tatsächlich ausgelieferte Antwort für die betroffene URL, nicht nur eine Einstellung im Redaktionssystem.
Ist eine Suchseite mit noindex privat?
Nein. Sie bleibt ohne zusätzlichen Zugriffsschutz öffentlich erreichbar. Vertrauliche Informationen müssen über geeignete Zugangskontrollen geschützt werden; Suchmaschinenanweisungen ersetzen diese Kontrollen auf keinen Fall.
Sollten Suchseiten in die XML-Sitemap?
Eine Sitemap sollte die tatsächlich gewünschten kanonischen Suchmaschinenzielseiten enthalten. Bereits bewusst ausgeschlossene Suchzustände dort gleichzeitig einzureichen erzeugt einen widersprüchlichen Veröffentlichungsplan und erschwert die Kontrolle.
Wie erkenne ich eine zu breite Ausschlussregel?
Testen Sie neben betroffenen Suchadressen ausdrücklich erlaubte Kategorien und Ratgeber. Wenn diese ebenfalls noindex erhalten, ist die Regel zu weit gefasst und muss vor dem weiteren Einsatz korrigiert werden.
Wissen anwenden.
SEO-Ausgangslage und nächsten Schritt besprechenQuellen und Einordnung.
Produktangaben nach öffentlich verfügbaren Informationen; Quellenstand 13.11.2026. Beispiele sind im Text gekennzeichnet.
Wissen weitergeben.